CLAUDE CODE SKILL

job-match-board

把一页 LinkedIn 岗位列表,变成一张对着你的简历算出来的求职看板。 给它简历和一个链接,它去把每个岗位的 JD 和公司资料真的抓下来,逐条对照你的经历, 判出匹配度、投中概率、你的优势、你的短板,以及今天该做什么。

git clone https://github.com/Bella-h12/job-match-board.git ~/.claude/skills/job-match-board 在 GitHub 上看 ↗

它到底改变了什么

LINKEDIN 给你的顺序

按竞价排的,不是按适合你排的

  • 01Junior Data AnalystKestrel Staffing · 12 个月合同猎头外包
  • 02Staff Research ScientistMeridian AI · 要博士 + 一作论文方向不对
  • 03Product AnalystVantage Analytics · 挂满一个月1,200 人已投
  • 04Implementation LeadAlder Cloud · 全远程 · 3 天前真正该投的

前三个都不该投,真正该投的排在你已经划走的位置。

它给你的顺序

按简历对得上什么 × 值不值得排

  • 01Solutions EngineerNorthwind Labs · 91 分 · 今天确认在招今天投
  • 02Implementation LeadAlder Cloud · 88 分 · 2 位校友在职今天投
  • 03Product AnalystVantage Analytics · 66 分仅内推时投
  • 04Junior Data AnalystKestrel Staffing · 25 分跳过

排第一的是你上周就该投、今天确认还开着的那个。不是新岗。

它每天先告诉你的,不是"有什么新岗"

投简历最费时间的不是写简历,是判断该投哪个。一页十几个岗位,人工开 JD、查公司、对简历要两小时, 第二天全忘了——于是每天重读同样的岗位,真正该投的那个一直躺在待办里。 这个 skill 每天做的第一件事是复查旧待办还开不开着,然后才看新岗。
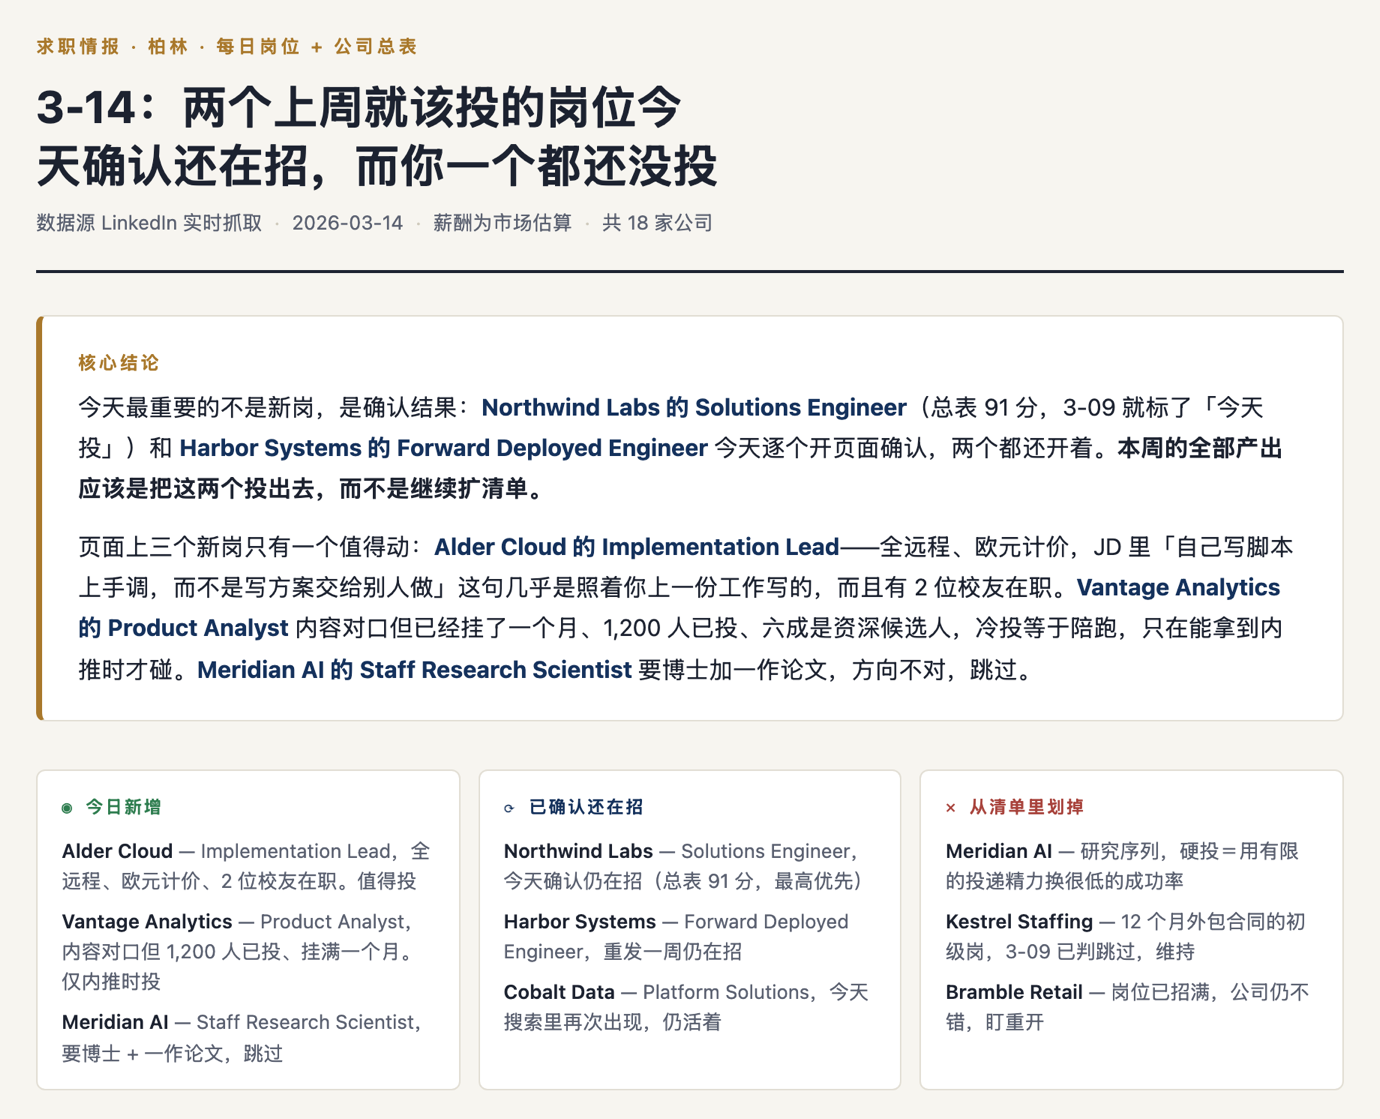
核心结论段落,指出两个上周就该投的岗位今天确认仍在招;下方三栏列出今日新增、已确认还在招、从清单里划掉的岗位
核心结论 + 今日变化三栏。结论先行:先说今天投什么、按什么顺序,理由放后面。三栏分别是新增了什么、哪些确认还在招、哪些划掉了——跨天状态一眼看完。

产出长什么样

下面全部来自仓库里的示例数据,人物、公司、数字都是虚构的。

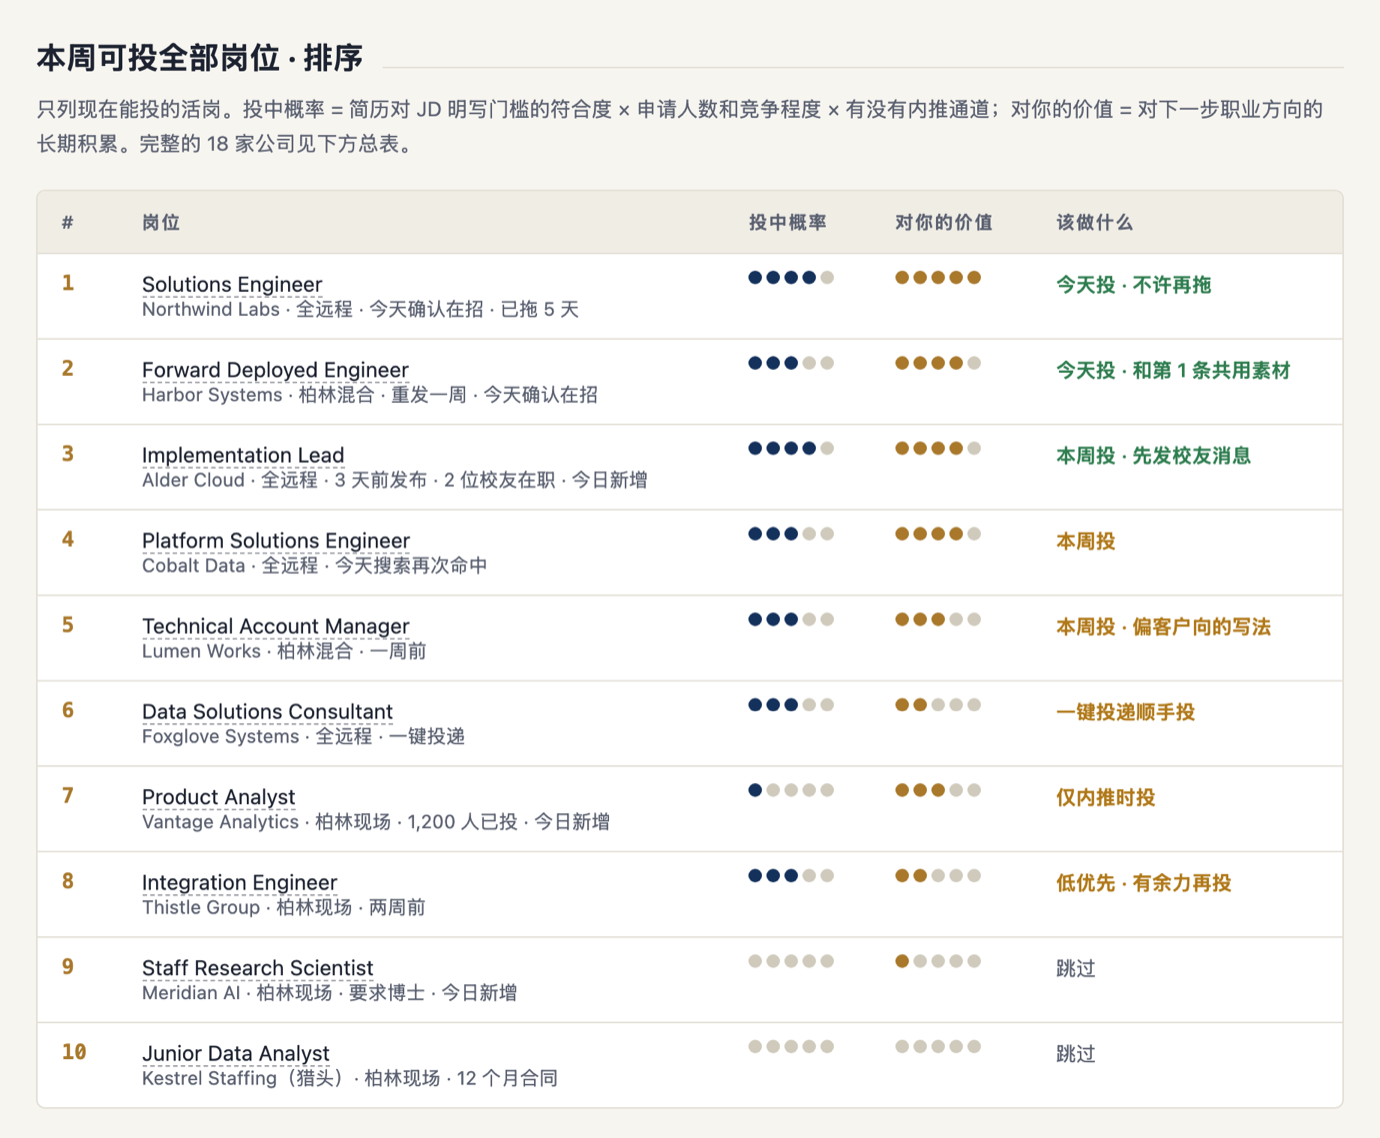
岗位排序表,每行有投中概率和对你的价值两列五点评分,以及该做什么
排序表:两个维度分开打分。投中概率和"对你的价值"是两件事。一个岗可能很好投但对你没用,也可能极有价值但基本没戏——合成一个分数就看不见这个区别。
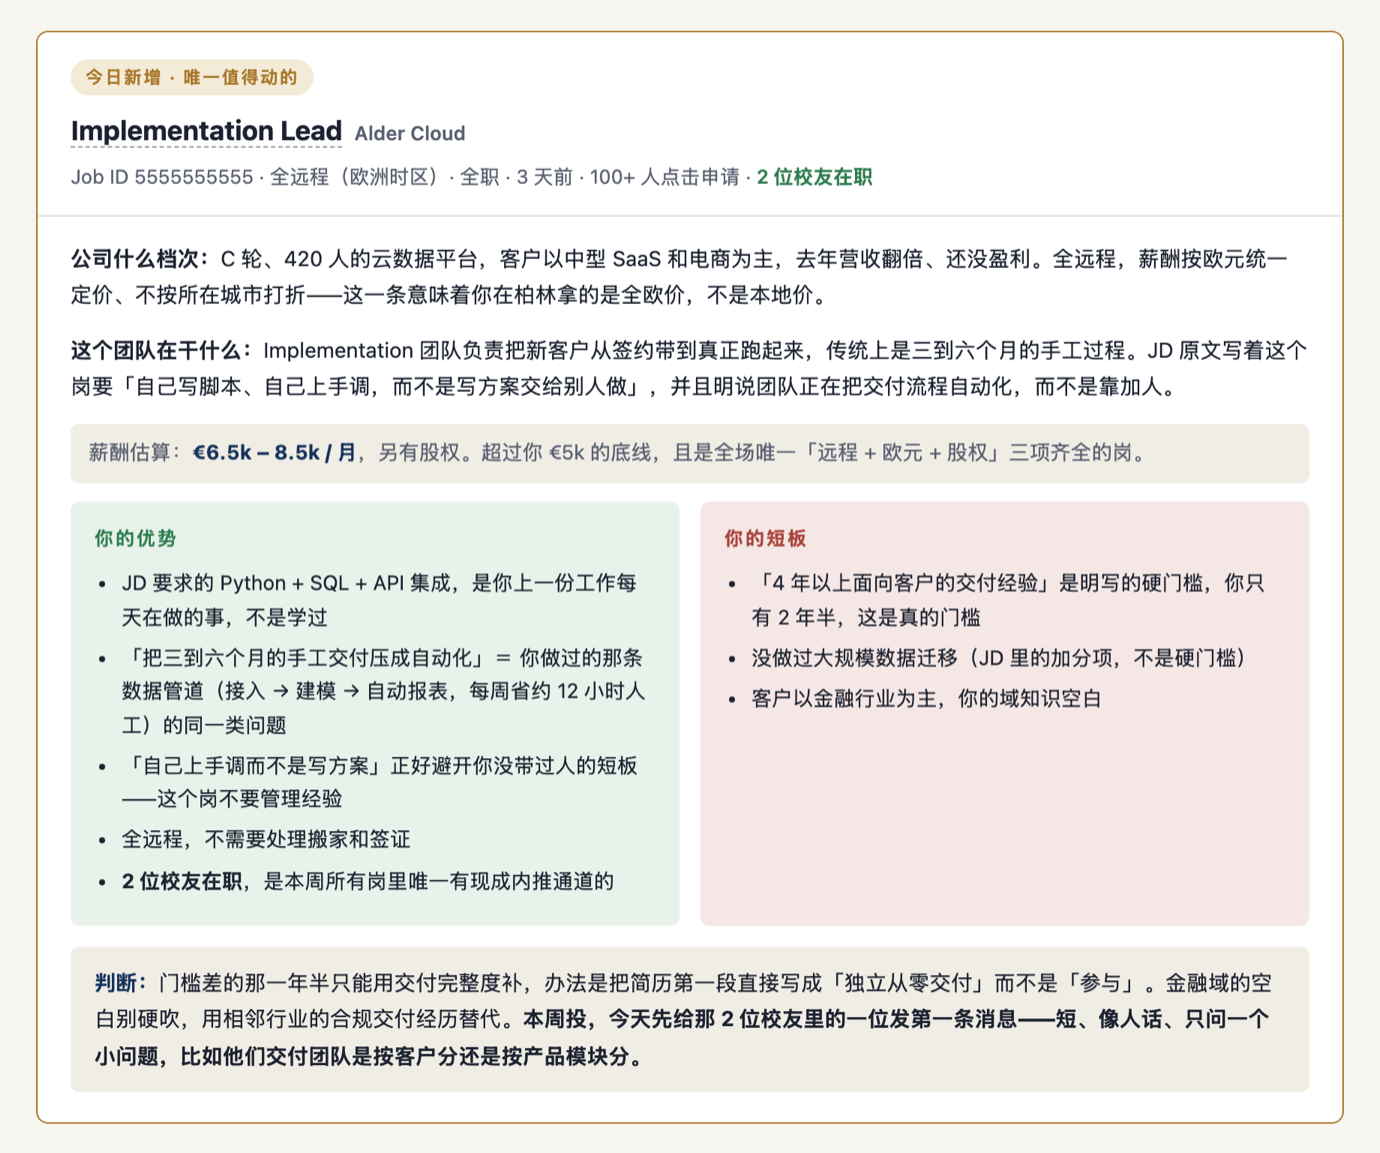
重点岗位深挖卡片,左侧绿色是你的优势,右侧红色是你的短板,底部是判断和具体动作
重点岗位:优势 / 短板双栏对照。优势那栏必须逐条引用简历里能举证的经历,对上 JD 的具体某一条;短板那栏必须区分明写的硬门槛和加分项,是硬门槛就说是硬门槛,不安慰。最后一句永远是一个具体动作,不是"优化简历"。
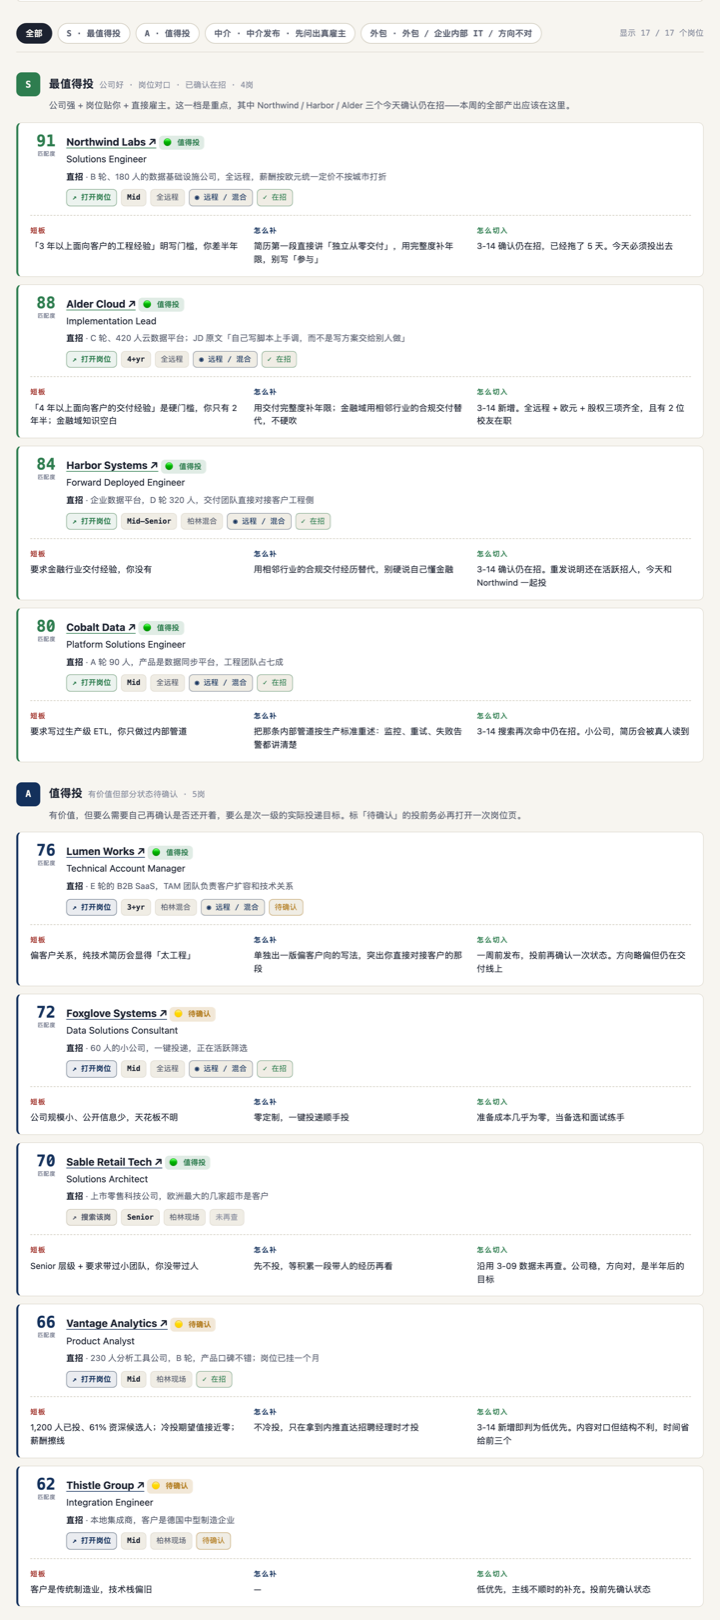
全部岗位总表,按 S / A / 中介 / 外包分档,每张卡片有匹配度分数、公司质量色灯、在招状态和三栏结论
全部岗位总表:可筛选,匹配度和公司质量分开标。分数只说岗位本身贴不贴你,公司好不好由色灯单独表示——混在一起,猎头发的完美 JD 会被顶到第一名。状态标记逼你诚实:只有当天真的开过页面确认的才能标"在招"。中介发布的岗位单独归一档,因为对它们该做的动作不是投递,是先问出真实雇主是谁。
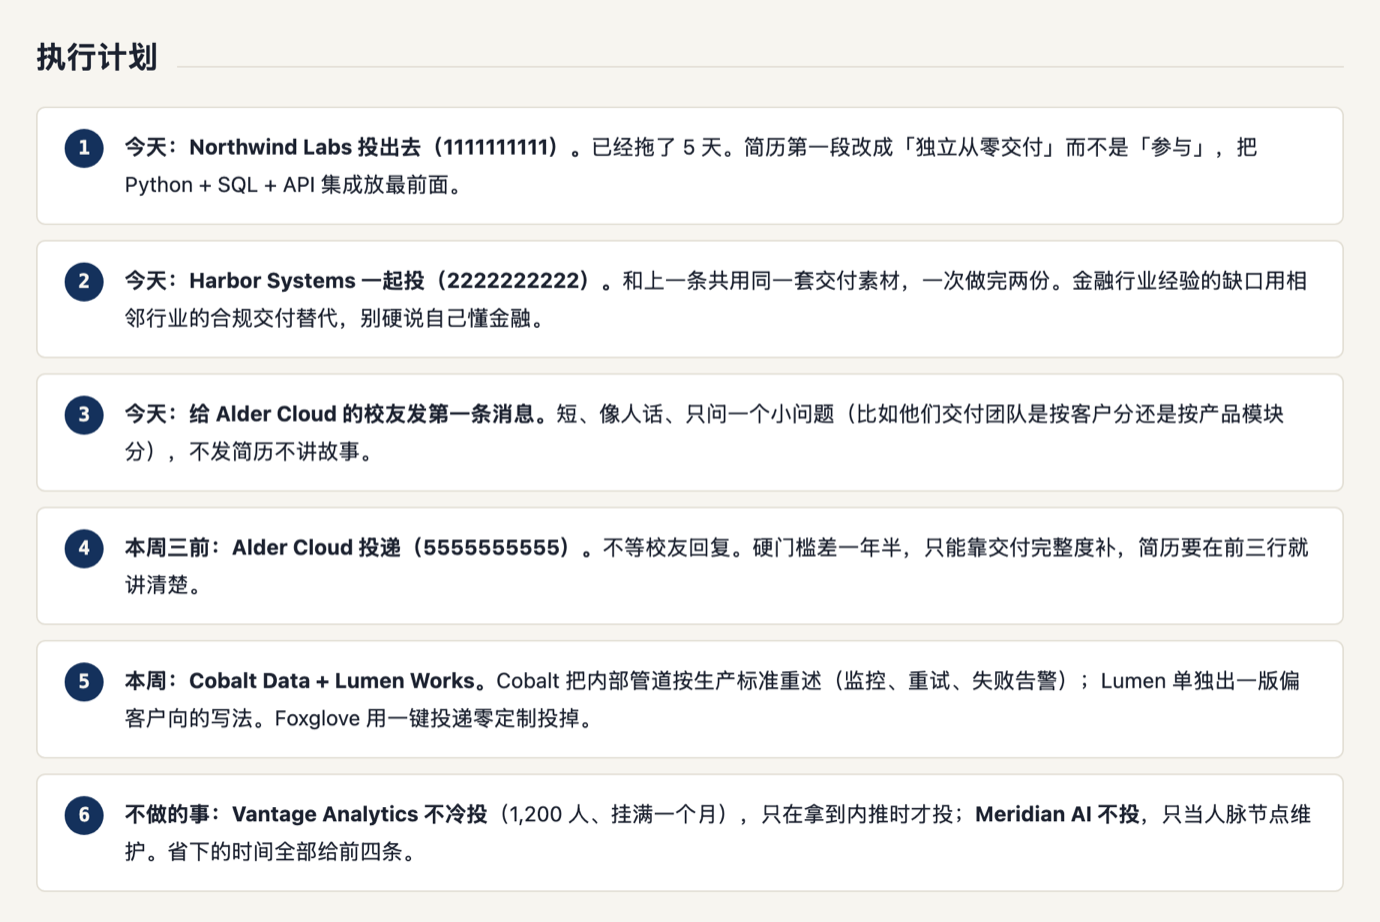
执行计划,按天排的具体动作,最后一条是明确不做的事
执行计划:按天排的具体动作,包括明确不做的事。最后一条永远是"今天不做什么、省下的时间给谁"——没有这条,清单只会越滚越长。

怎么用

装好之后在 Claude Code 里直接说话,或者用 /job-match-board 触发。

帮我分析这页岗位
简历在 ~/Documents/resume.pdf
https://www.linkedin.com/jobs/search-results/?currentJobId=…
  1. 两个必需输入:简历 + 岗位页链接。缺简历它会明说「只能列岗位、判不了匹配」,让你选补简历还是接受降级版本——不会假装分析过。
  2. 第一次跑会问三件事,问完存进 profile.json 复用:薪酬底线(没有底线就判不了"擦线"还是"远超")、地点与远程偏好、在找什么方向(决定哪些岗直接进不投清单)。
  3. 它从 URL 里抠 Job ID。这类个性化推荐页用关键词搜索复现不了,URL 里的 currentJobId 和 originToLandingJobPostings 是唯一可靠的锚点,一个不落全抓。
  4. 抓的是真数据:JD 全文、公司规模、员工增速、中位任期、申请人数、申请人资历分布、有没有校友或前同事在职。
  5. 之后每天只丢一个新链接。已分析过的岗位不重写,只标状态变化;发布到同一个固定链接,你的书签不用换。

分析和出页面是分开的

分析产出一个 board.json,构建脚本负责把它变成 HTML。 所以你也可以手写 JSON 直接拿它当静态页生成器用,不经过 Claude。

python3 scripts/build_board.py examples/board.example.json /tmp/demo.html
python3 scripts/test_build.py

构建脚本先校验再渲染,出错带位置:
构建失败:$.board[2].light = 'blue',只能是 ['green', 'red', 'yellow'] 之一
16 条回归用例里有 11 条是反例——断言"这种输入必须报错"。每一条都撤掉对应的校验确认过它会变红: 只能变绿的测试教人忽略红色。

几条设计上的固执

这些不是配置项,是这个工具的立场。

匹配度和公司质量分开算

混在一起,竞价买来的排序会伪装成好机会。猎头能写出一份完美贴合你的 JD,那不代表那份工作存在。

短板必须诚实

明写的 required 就说是硬门槛,不安慰。简历里没有的经历不替你吹出来——面试会当场穿帮,代价比少投一个岗大得多。

状态不许装作知道

当天真的开过页面确认的才标"在招",沿用旧数据的标"未再查"。一个已经招满的岗位挂在第一位,比没有这张表更糟。

说人话

不用军事和游戏比喻(弹药、靶位、赛道、打法),不用行业黑话。"你的优势""你的短板""怎么切入"就够了。

每天先复查旧待办,再找新岗

一个上周就该投、今天确认还开着的好岗位,比三个新岗更重要。清单越滚越长是求职里最常见的自我安慰。